
今天 5 件事:GLM 5.3 在 CyberGym 封頂、DeepSeek 漲價 2.6 倍、token 計價的披薩陷阱、Qwen 3.8 與 Meta Muse Glimmer 領軍的開源週、X 把 For You 推薦演算法整個攤開。
GLM 5.3 摘下 CyberGym 桂冠,兩週後開源
Z.ai 的 GLM 5.3 在安全漏洞挖掘基準 CyberGym 拿下 84.5%,壓過 Anthropic Mythos(83.8%)與 OpenAI GPT-5.6 Sol(83.6%)——中國模型首次在這條基準上登頂。
- 同一個 base model 與 GLM-5.2 完全相同,全部提升來自 post-training scaling
- ExploitBench:24.4% → 54.4%
- ExploitGym:兩小時完成任務 29 → 105
- 權重兩週後以「公共財」姿態開源,MIT 授權
為什麼重要:基座能力的庫存比想像中深,後訓練是下一個主戰場。

圖:CyberGym 榜單
來源:@NuryVittachi(輔證:@kimmonismus 詳解 post-training 增益機制)
DeepSeek V4 Pro 0813:變強,也變貴
新版旗艦在 Artificial Analysis 智慧指數拿 53 分(+8),維持 MIT 開源,仍站在性價比前緣——但計價結構徹底改寫。
- Blended price:+264%
- Cache 命中:舊價約 $0.0037 / 1M → 新價 $0.044 / 1M(12 倍)
- 離峰仍有 50% 折扣
- 新價 2026-08-16 生效——就是今天
為什麼重要:「DeepSeek = 免費午餐」時代收尾。想守住利潤只剩兩張牌:cache 命中與離峰排程。

圖:AA Intelligence Index 對比
來源:@ArtificialAnlys
Tibo:token 計價是披薩陷阱
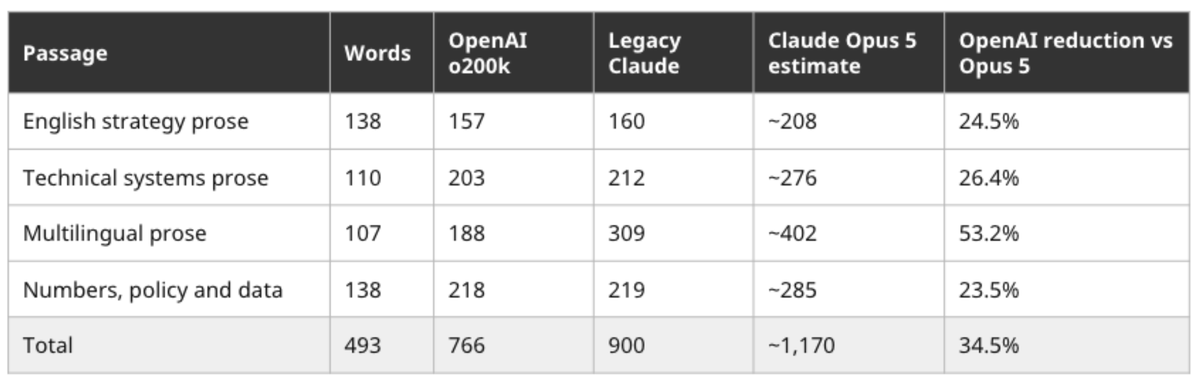
前 OpenAI 工程師 Tibo 算給你看:同一段文字,GPT-5.6 Sol tokenizer 要 766 tokens,Claude Opus 5 要約 1,170——多付 34.5% 而你帳單上看不出來。
「披薩切 16 片每片比較便宜,但整個餅更貴。每百萬 token 單價不是帳單,每個『成功結果』的價格才是。」
- 跨模型比較計價時,先看 tokenizer 差異
- 『每個成功結果的單價』才是選模型指標,benchmark 只是起點
- 自家工作流的真實成本要自己測,不能看型錄價
為什麼重要:當開發者嫌 Opus 5 貴時,很可能不是 5 貴,而是它的 tokenizer 比較不經濟。

圖:tokenizer 比較
來源:@thsottiaux
開源洪流倒數:Qwen 3.8、Muse Glimmer、LTX 2.5
未來兩週有 5+ 個有分量的開源權重排隊釋出:
- Qwen3.8 2.4T A95B 權重已發布,27B 版本倒數
- Meta 超級智慧實驗室首發:Muse Glimmer 30B(直接對標 Gemma 4 31B)
- LTX 2.5、Nemotron-Lighting、DeepSeek V4 Pro 0813
Simon Willison 已在 M5 Max 筆電上跑 Qwen 3.7 27B(17GB GGUF),畫出他看過最好的 pelican on a bicycle——本地推論的實用性已經到位。

為什麼重要:兩個超大玩家(Meta 與阿里)同步加碼,「本地能跑的頂級模型」這個賽道正式開打。
來源:@simonw(輔證:@analogalok、@kimmonismus)
X 把 For You 演算法真的開源了
xai-org/x-algorithm 釋出的不是白皮書——是真傢伙:
- home-mixer 主排序管線
- Thunder:in-network 排序
- Phoenix:out-of-network 檢索與評分
- visibility filter 的實際權重
- 配「Under the Hood」工具:查自己帳號被貼了什麼標籤
為什麼重要:推薦系統從黑箱變公共財,shadowban 從都市傳說變可驗證的事實。
來源:@BrianRoemmele
結語
Tibo 深夜一句「What's your /goal for the night?」拿了 1,800 讚——前 OpenAI 工程師的產品伏筆,值得追蹤。


No comments yet